

Split Agent: バッチスキャンの分離
7ページのバッチスキャンが、ファイル名に文書タイプ、日付、差出人を含む5つのドキュメントに変換されます。元のスキャンは保持されます。
学べること
- PremiumティアのSplit Agentを作成し、自動分離を有効にします
- ドキュメントリストからバッチスキャンを分離し、モニターで結果を確認します
文字起こしを非表示 文字起こしを表示 完全な文字起こし
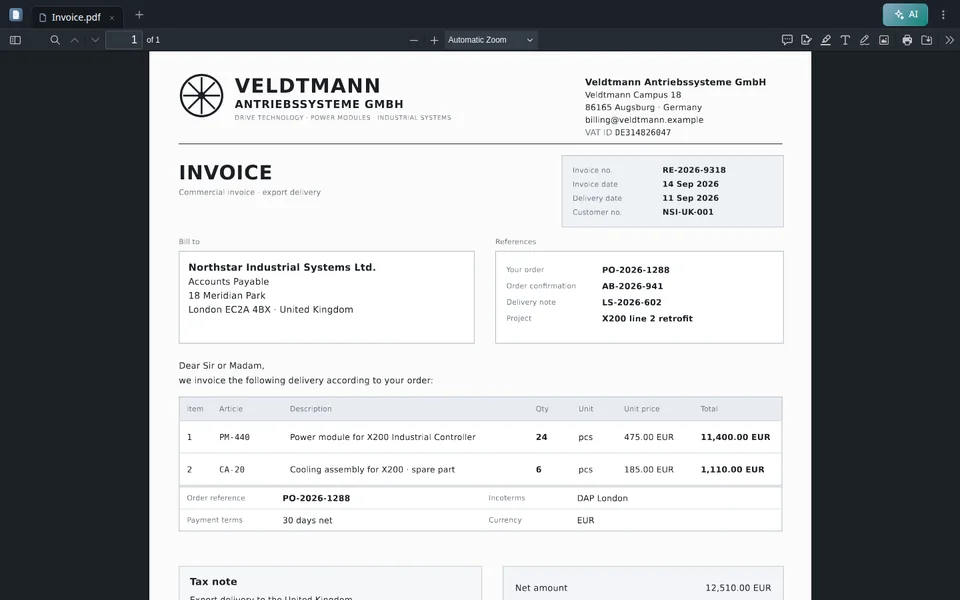
最初の課題:郵便室では、書類の束を一括でスキャンします。その結果、発注書、納品書、請求書などを含む区切りシート付きの7ページのPDFが作成されます。この目的のために、Split Agentを作成します。名前を「Split mailroom」とし、レベルとしてPremiumを選択します。これにより、個々の部分には番号だけでなく、文書タイプ、日付、差出人がファイル名に付与されます。「Split」メソッドタブでは、エージェントが新しいドキュメントの開始位置をどのように認識するかを定義します:自動検出、表紙ページによるもの、区切りコードによるもの、文書タイプの変更によるもの、固定ページ数後、個人またはファイルごと、または独自ルールによるものです。ここでは「Automatic」のままにします。その後、PaperOfficeがコンテンツ、差出人、日付、文書タイプに基づいて境界を検出します。区切りシートは可能ですが必須ではありません。ターゲットとして既存のWorkspace「Mailroom 2026」を選択します。次にバッチスキャンの設定を行います:リストから項目を選択し、「Actions」>「Split」>「Run via Split Agent」をクリックします。「Start」をクリックすると、エージェントがバックグラウンドで処理を行います。約1分後、モニターに作成されたドキュメントが表示されます:7ページから5つのドキュメントが生成され、それぞれファイル名に文書タイプ、日付、差出人が含まれています。区切りシートは削除され、元のスキャンは保持されています。リストを軽く確認する価値はまだあります:分離が正しい場合、通常通りデータフィールドやワークフローなどを進めることができます。新しいドキュメントの一つ(Veldtmannへの注文)を確認すると:PaperOfficeはタイトルと金額を含む要約とともに、他のドキュメントと同様に抽出しています。