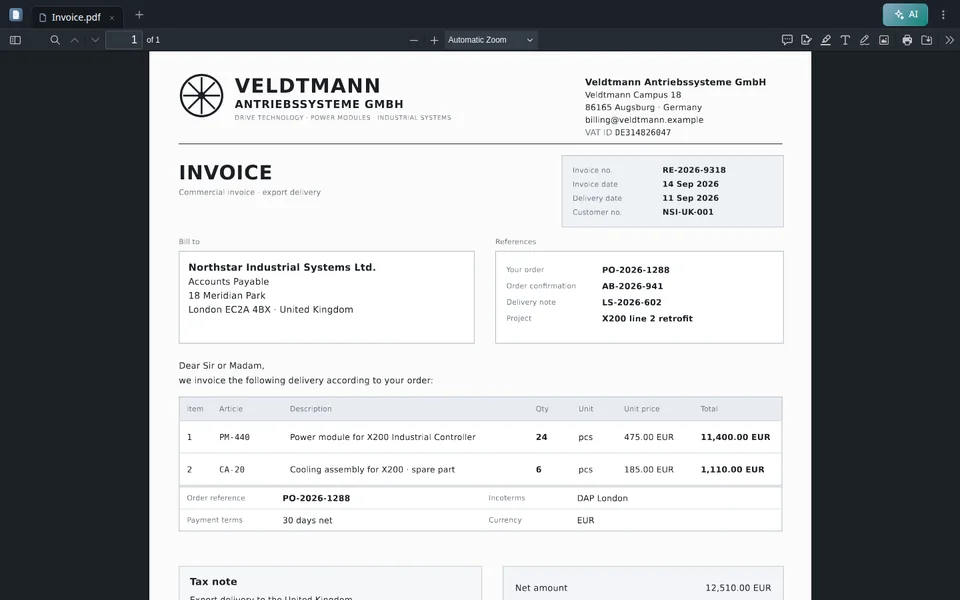
Redact Agent は PDF 内の個人データを見つけ、スキャンして黒塗りします。各黒枠の下のテキストは削除され、元の文書は変更されません。保存された Redact Agent はすべての設定を保持し、サーバー側で選択したドキュメントを処理します(例:GDPR 遵守のための共有前、記録請求時、またはアーカイブ用)。
文書の準備
PDFファイルをWorkspaceに格納してください。エージェントは文書一覧で選択した文書を処理します。スキャン文書はOCRで読み取られます。
Redact Agent の作成
「Document AI → Redact Agent」を開き、「Redact Agent の作成」をクリックします。「一般」でエージェントに明確な名前を付け、AI タイアを選択します:15ページまでの簡単な文書用には Basic、50ページまでのスキャン、表、フォーム用には Premium、100ページまでの機密ファイル用には Ultra。
プロフィールを選択してください
「シナリオ」で13種類のプロフィールのいずれか(例:GDPRリクエスト、外部共有、HRファイル、財務データなど)を選択します。プロフィールは、どのカテゴリを黒塗りし、どの情報を表示させるかを定義します。「カスタム」プロフィールでは、カテゴリを自分で選択できます。
例外と追加用語を定義する
「ファインチューニング」で、常に黒塗りしない用語(例:社名など、「黒塗りしない(ホワイトリスト)」)と、常に黒塗りする用語(例:事件番号など、「追加で黒塗り(ブラックリスト)」)を入力します。カスタムAI指示はオプションです。
出力設定を行う
「出力」で、個人情報やボックスの色を塗りつぶしたコピー用の既存のWorkspaceまたは新しいWorkspaceを選択してください。塗りつぶしに代わる擬似匿名化(データを架空の値に置き換えること)にはUltraが必要であり、すべてのプロファイルで利用可能なわけではありません。「変更を保存」をクリックしてください。
数件のドキュメントでテスト
ドキュメント一覧で典型的なPDFを2〜3件選択し、「アクション」→「エージェントとワークフロー」→「Redact」→「Redact Agentで自動実行」をクリックします。エージェントを選択して「REDACT AGENTを開始します」をクリックしてください。単一のドキュメントの場合、まずプレビューが開き、各マークされた領域とそのカテゴリおよび理由が表示されます。ターゲットのWorkspaceにあるコピーで個人データが非表示になっていることを確認してください。不足がある場合や黒塗りが多すぎる場合は、エージェントのプロファイル、ホワイトリスト、またはブラックリストを調整して再テストしてください。
バッチ処理を実行
テスト結果が適切であることを確認したら、残りのPDFを選択し、同じ方法でエージェントを開始します。複数のドキュメントはサーバー側で一度に4件ずつプレビューなしで処理されます。「処理中」ジョブモニターで進行状況を確認してください。料金はAIティアに応じて、処理されたページ数に基づいて課金されます。
自動化
Workspaceルールにより、新しいアップロードが自動的に黒塗りされる機能は存在しません。新しいドキュメントについては、REST API (POST /documents/redact-agent-run) を介してご自身のシステムから保存されたエージェントを開始してください。製品ページの技術リファレンスに呼び出し方法が記載されています。