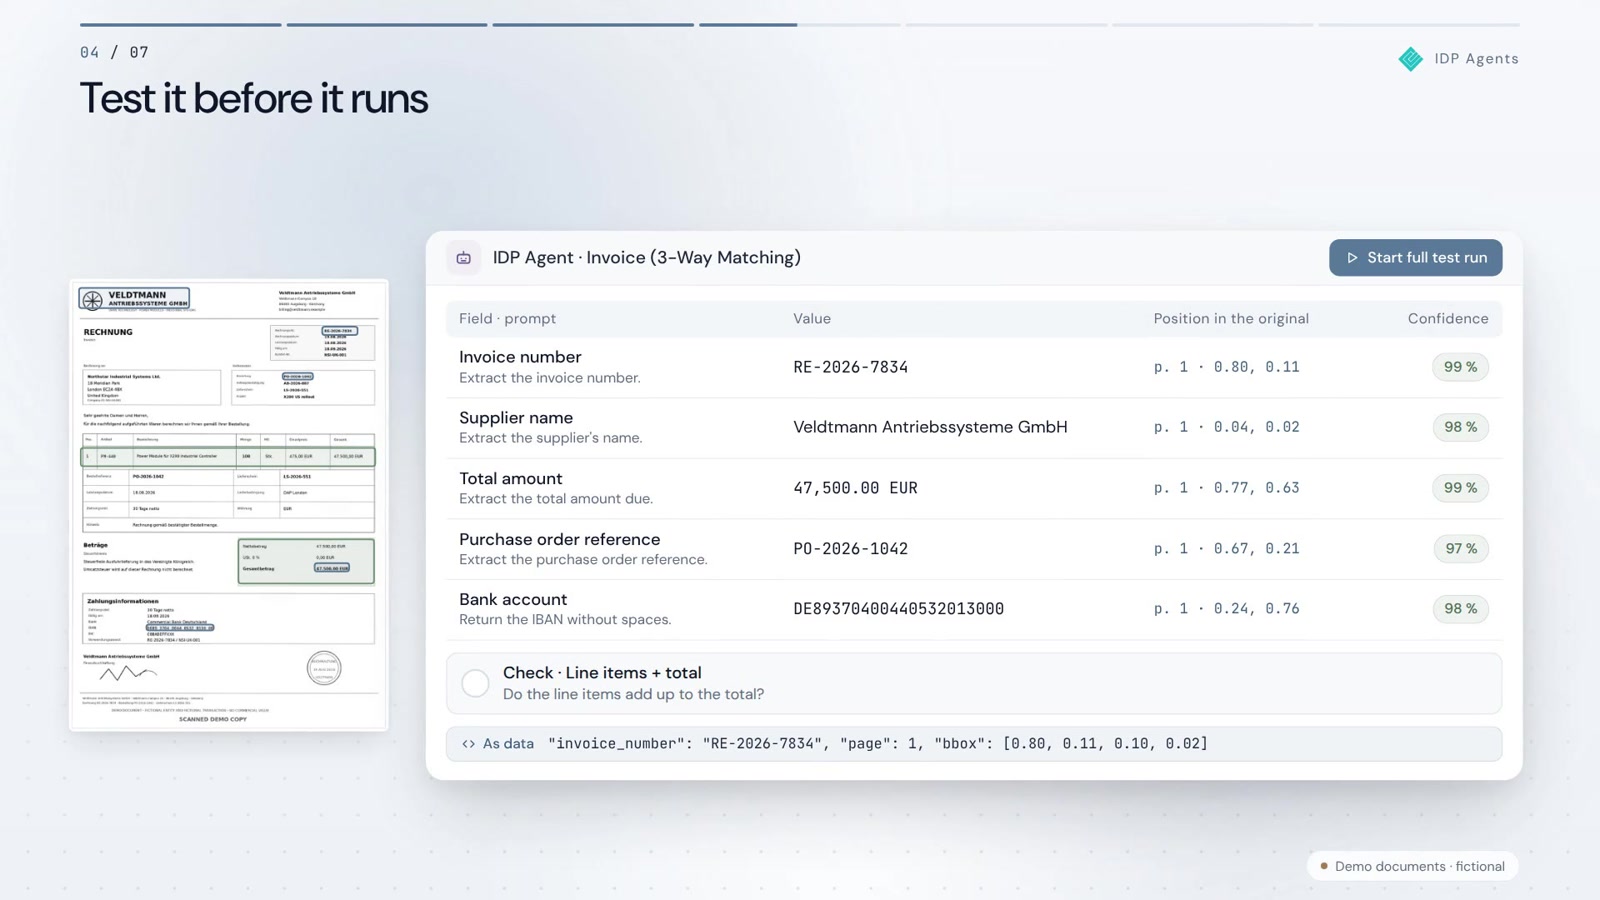
サンプルデータ、架空の値
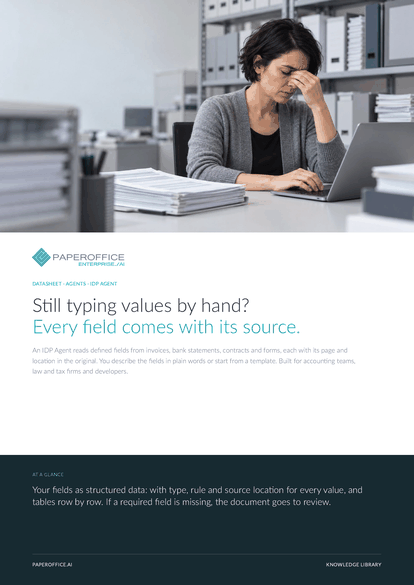
既製の文書タイプまたは独自のプロンプトから始める
IDPエージェントには、レイアウトテンプレートもトレーニングデータも必要ありません。請求書、契約書、納品書、身分証明書、税務書類など、60種類以上の既製文書タイプから選択できます。または、フィールドをご自身の言葉で記述してください:「サプライヤー、請求書番号、数量と価格を含む明細」。プロンプトコーチが適切なフィールドを提案します。
データシートを読むIDPエージェント
テンプレートではなくプロンプトで
AIが請求書、領収書、契約書、各種フォームを読み取り、構造化データをお客様のシステムへ提供します。テンプレートもトレーニングも不要です。
PaperOffice 導入企業
Playground
サンプルを選んでください。エージェントが項目を抽出し、文書内の位置をそれぞれ示します。ログインは不要です。
架空の値を使ったサンプル文書です。
お客様独自の書類
登録後、アプリでご自身のファイルをアップロードできます。
動画を見る · 1:24
インテリジェントな文書処理(IDP)は、請求書、契約書、スキャン文書などの非構造化文書を構造化データに変換します。テキスト認識(OCR)と、文書を理解するAIを組み合わせ、ソフトウェアが文書を分類し、フィールドを抽出・検証して次の処理へ渡します。PaperOffice AIでは、IDPエージェントがこれを行い、各フィールドを値、信頼度スコア、文書内の位置とともに返します。
請求書から身分証明書まで、60種類以上の既製文書タイプ
定義、テスト、実行
フィールドを平易な言葉で記述し、結果をテストしてから、エージェントを手動、バッチ、またはワークスペースで自動実行します。
サンプルデータ、架空の値
IDPエージェントには、レイアウトテンプレートもトレーニングデータも必要ありません。請求書、契約書、納品書、身分証明書、税務書類など、60種類以上の既製文書タイプから選択できます。または、フィールドをご自身の言葉で記述してください:「サプライヤー、請求書番号、数量と価格を含む明細」。プロンプトコーチが適切なフィールドを提案します。
データシートを読むサンプルデータ、架空の値
各フィールドには、タイプ、プロンプト、ルール(必須、パターン、許容値、ページ範囲)が設定されます。テスト実行では、各値がページ上のどこで見つかったかが表示されます。最大10回繰り返して、エージェントを本番稼働させる前に結果が安定しているかを確認できます。
サンプルデータ、架空の値
同じエージェントが5つの場所で実行されます。アプリ内では、1件の文書に手動で、任意の数の文書に一括で、そしてワークスペース内のすべての新しい文書に自動で。外部からは、REST API経由で、またClaude、ChatGPT、CursorのMCPツールとして。
開発者向け
アプリで作成したエージェントを、1回のRESTリクエストで呼び出せます。レスポンスはJSON形式で、ページごとに各フィールドの値、信頼度スコア、バウンディングボックスが含まれます。直接レスポンスを待つか、ジョブIDを受け取り、ポーリングまたはWebhookで結果を受信します。
各フィールドに値、信頼度、位置情報を含み、ページごとに出力されます。
直接応答にはclient_waitを使用し、それ以外の場合はジョブIDとポーリングまたはWebhookを使用します。
同じエージェントを、Claude、ChatGPT、Cursorのツールとして利用できます。
プロンプト例https://paperoffice.ai/llms.txt を読み、./inbox 内のすべての請求書から次のフィールドを抽出するスクリプトを書いてください:サプライヤー、請求書番号、請求日、総額。
出力例
CursorやClaude CodeなどのAIエディタでの実行例です。値は架空のものです。すべての値は信頼度スコアと文書内の位置とともに返されます。
curl -X POST \ "https://api.paperoffice.ai/latest/documents/idp-agent-run" \ -H "Authorization: Bearer po_ut_YOUR_API_KEY" \ -F "idp_agent_id=YOUR_AGENT_ID" \ -F "file=@./invoice.pdf" \ -F "client_wait=1"curl -X POST \ "https://api.paperoffice.ai/latest/job/add/workflow" \ -H "Authorization: Bearer po_ut_YOUR_API_KEY" \ -F "file=@./invoice.pdf" \ -F "idp_collection=invoice" \ -F "model=basic-pro-max"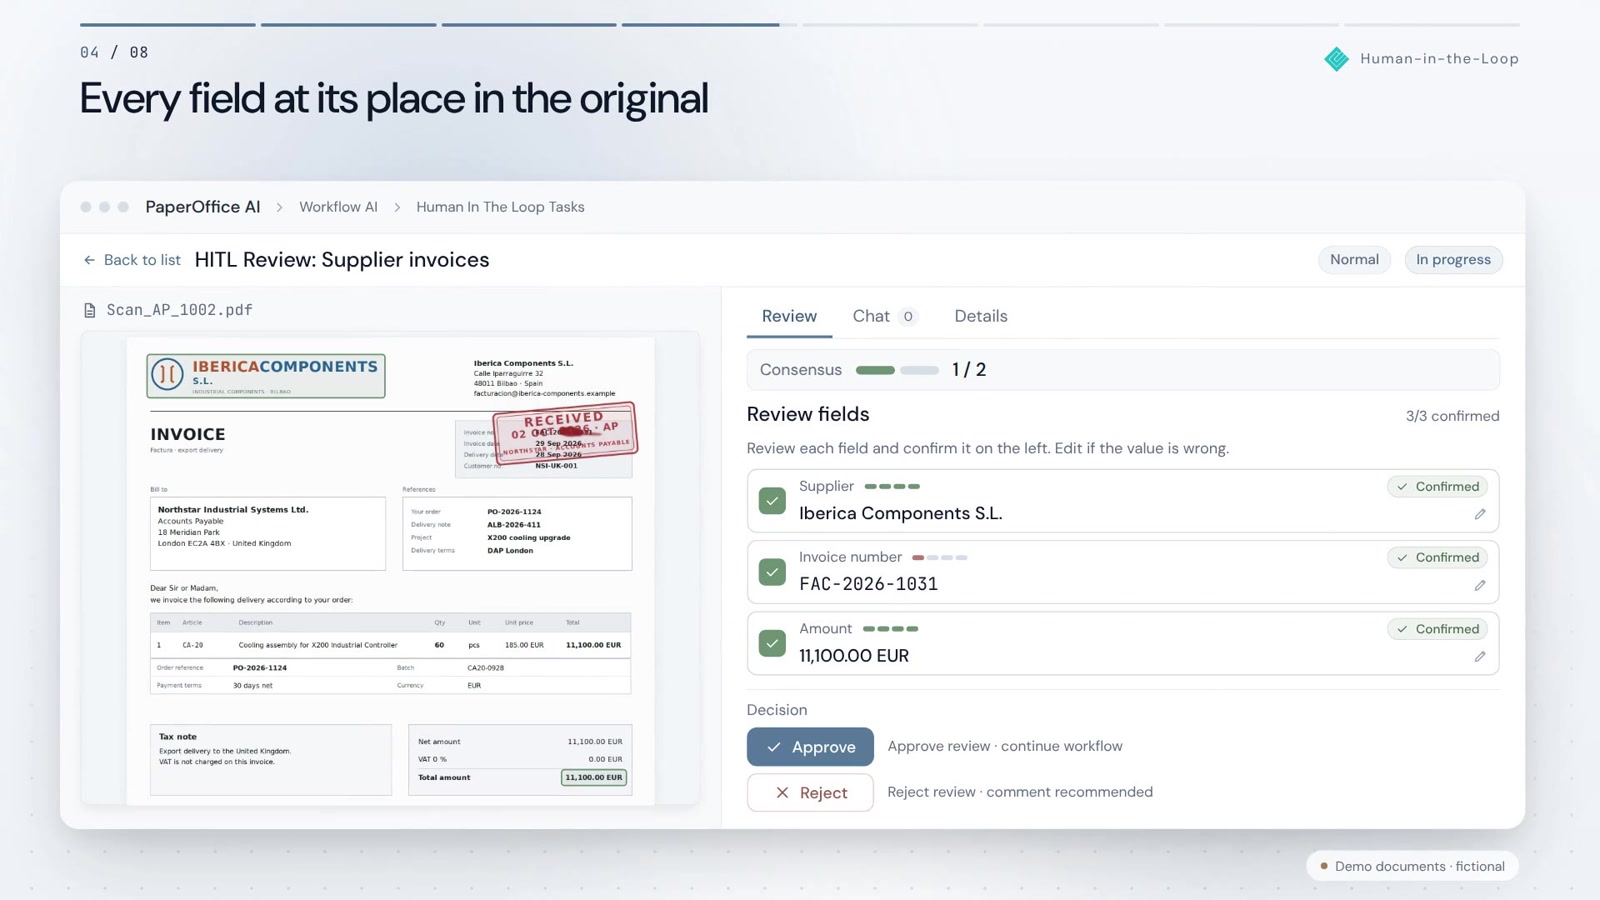
欠落が見過ごされることはありません。必須フィールドが欠けている場合、文書はエージェントの検証キュー(ヒューマンインザループ)に送られます。設定すれば、抽出に失敗した場合も同様です。検証者は各フィールドを原本上の位置とともに確認し、承認、修正、またはエスカレーションします。それ以外のすべての文書は止まることなく処理されます。
ヒューマンインザループの仕組みIDPエージェントは文書タイプを認識し、定義したフィールドを読み取り、ルールに照らしてチェックし、各フィールドを値、信頼度スコア、位置とともに返します。必須フィールドが欠けている場合は人が検証します。設定すれば、抽出に失敗した場合も検証します。
エージェントの起動方法
エージェントの動作
必須フィールドが欠けている場合は人が検証します。設定すれば、抽出に失敗した場合も検証します
データの活用方法
IDPエージェントが読み取れる82の文書言語
導入事例
3社のお客様、3つの導入事例。
Intelligenceティアで1文書あたり最大3,000ページ
機能
アプリで設定した内容は、APIとMCPでも同様に適用されます。
主な機能
抽出したい内容を記述するだけ。スキーマ、トレーニング、レイアウトテンプレートは不要です。
フィールドごとにタイプ、必須、パターン、許容値、ページ範囲を設定。
各値にはページ上の位置が付与され、監査や検証に利用できます。
スタンプ、チェックボックス、署名、手書きの記入を認識します。
Intelligenceティアは、最大3,000ページの文書全体で合計値や関連性をチェックします。
品目、数量、価格を含む明細を、複数ページにまたがる場合も表として出力。
日付、数値、通貨をお客様の地域の形式で出力。
1〜10回テストし、フィールドごとのヒット率を確認できます。
エージェントは82の言語の文書を読み取り、言語を自動検出することもできます。
ゼロショット抽出レイアウトテンプレートやトレーニングデータなしでのデータ抽出
比較
次の文書の見た目が異なる場合、何が起こるか。
テンプレートベースのIDPは、レイアウトが変わるたびに調整が必要です。追加システムのない単体のLLMは、ほとんどのレイアウトに対応できますが、位置情報、ルール、人による検証、アーカイブは、お客様がその周りに構築する必要があります。IDPエージェントには、ルール、位置情報、ヒューマンインザループ、監査証跡、アーカイブが統合されています。
| 比較 | テンプレートベースのIDP | 追加システムのない単体のLLM | IDPエージェント(統合型) |
|---|---|---|---|
| 新しいフィールドを追加 | 新しいテンプレート | 新しいプロンプト | 1フィールドに1プロンプト |
| レイアウトの変更 | テンプレートの調整が必要 | ほとんどのレイアウトに対応 | レイアウトテンプレート不要 |
| 値の位置を検証可能 | テンプレートによる | 標準では非対応 | フィールドごとのバウンディングボックス |
| 検証と必須フィールド | テンプレートごとの固定ルール | 自社で構築が必要 | ルールとヒューマンインザループ |
| アーカイブ内で自動実行 | 別途統合が必要 | 自社で構築が必要 | ワークスペースの自動化とワークフロー |
| 課金 | ベンダーによる | 通常はトークン単位 | ユーザー単位ではなく使用量に応じて |
単発の作業にエージェントは必要ありません。オンラインツールで、テキスト認識(OCR)、手書きの変換、電子請求書のチェックが行えます。
信頼性、検証、パートナーシップ
ClaudeとChatGPTで検証済み、ISO/IEC 27001:2022認証取得
、そしてQNAPとASUSTORの唯一の公式DMSパートナーです。
対象範囲:
MCPコネクタを検証済みです。
詳細を見るMCPプラグインを検証済みです。
詳細を見る
唯一の公式DMSパートナー。
詳細を見る
唯一の公式DMSパートナー。
詳細を見る処理したページごとに課金されます。モデルのティアに応じて1ページあたり30クレジットから(最大400)。ユーザーアカウントはプランに含まれます。Solo Pro以上のプランは 料金ページでご確認いただけます。
よくある質問
OCRは画像をテキストに変換します。IDPはさらに一歩進み、どのテキストが請求書番号、合計金額、サプライヤーなのかを理解し、値をルールに照らしてチェックし、フィールドとして返します。PaperOfficeでは、OCRはIDPエージェント内の1つのステップです。Visionティアは、手書き、スタンプ、チェックボックスも読み取ります。
インテリジェントな文書処理のための保存済み設定です:文書タイプ、プロンプト付きのフィールド、モデルティア、検証ルール。一度作成すれば、何度でも実行できます:手動、バッチ、ワークスペースでの自動実行、REST API経由、またはMCPツールとして。
いいえ。フィールドを自然言語で記述すれば、エージェントは例なしで動作します(ゼロショット抽出)。60種類以上の文書タイプを含むカタログは出発点であり、必須ではありません。
PDF、スキャン文書、画像:XRechnungやZUGFeRDを含む請求書、契約書、納品書、発注書、銀行取引明細書、身分証明書、税務書類、手書きを含むフォーム。
すべてのフィールドには信頼度スコアとバウンディングボックスが付いているため、各値を文書と照合して確認できます。テスト実行は最大10回繰り返すことができ、結果の安定性を確認できます。ルールで判断できないものは、人による検証に回されます(ヒューマンインザループ)。
課金はユーザーごとのライセンスではなく、処理したページごとの使用量に基づきます。Solo Pro以上のプランは料金ページでご確認いただけます。ティアに応じて、1ページあたり30〜400クレジット(定価で€0.03〜€0.40)を消費します。
ワークスペースでエージェントチェーンを定義します。新しい文書はすべて、AI-DMS検出を経て、その文書タイプのデフォルトエージェントとワークスペースのチェーンを通過します。ワークフローには独自のIDPノードがあり、カタログの文書タイプを使って動作します。
REST APIによる1回の呼び出しで直接レスポンスまたはWebhookを受け取る方法、Claude、ChatGPT、CursorのMCPツールとして使う方法、またはコネクタ経由で既存のシステムに接続する方法があります。
PaperOfficeは、スペインのPaperOfficeデータセンターで自社ハードウェアを運用しています。保存されたすべての元ファイルは、AES-256で暗号化されたアーカイブとして保管されます。お客様独自のストレージ(BYOS)では、お客様独自のパスワードで暗号化します。ISO/IEC 27001認証取得(証明書は公開で確認可能)。
いいえ。ロボティック・プロセス・オートメーション(RPA)は、既存のシステム上でクリックやキー入力を固定ルールに従って繰り返します。IDPは文書を読み取り、データに変換します。両者は互いに補完し合います:IDPがフィールドを提供し、ワークフローやRPAボットがそれを次へ渡します。
追加システムのない単体のLLMは、ほとんどのレイアウトに対応できます。しかし、各値の位置、必須フィールドのルール、人による検証、アーカイブへの保管は標準では備わっておらず、お客様がその周りに自分で構築する必要があります。IDPエージェントにはこれが統合されています:すべての値の位置を返し、各フィールドをルールに照らしてチェックし、欠落は人による検証に回します。
IDPエージェントは82の言語の文書を読み取り、設定すれば文書の言語を自動検出します。